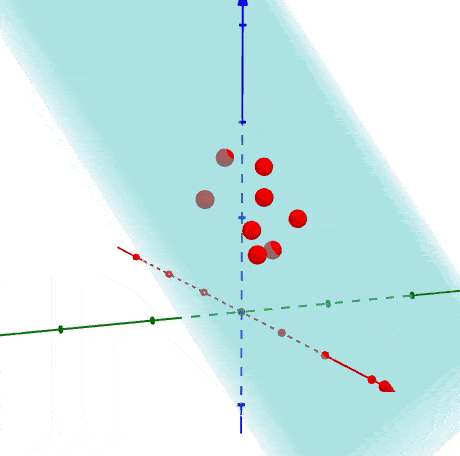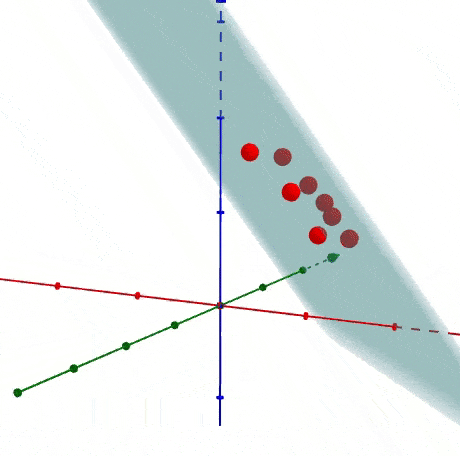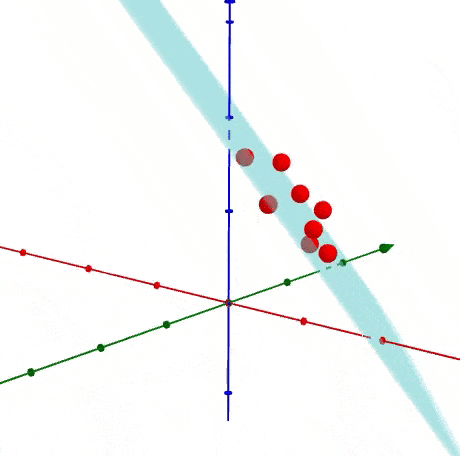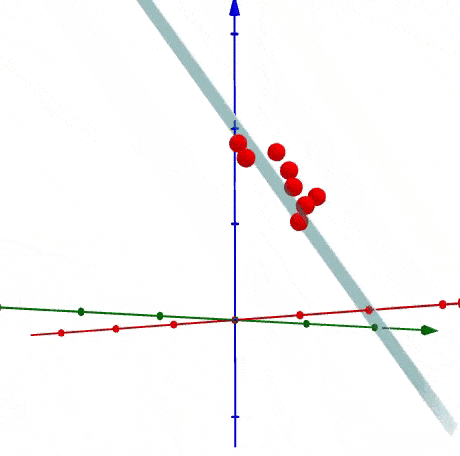
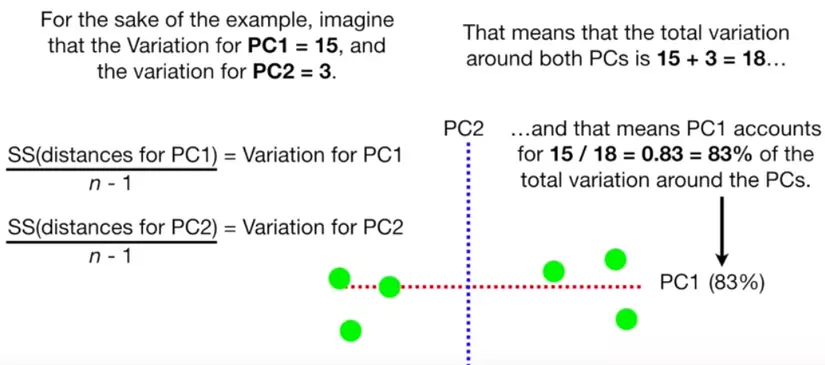
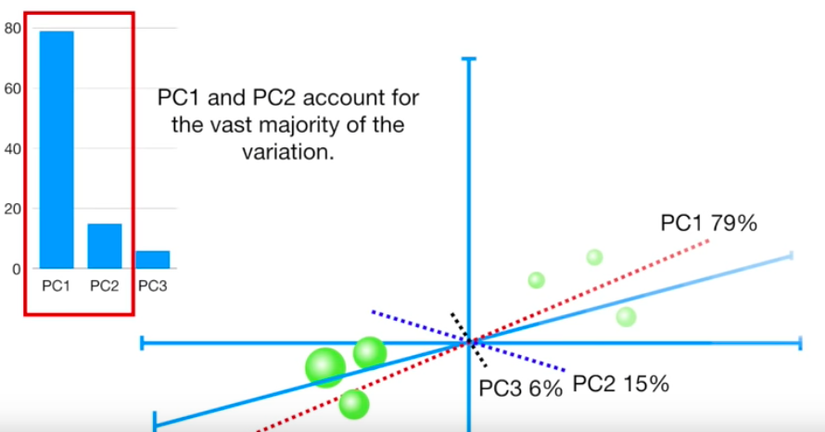
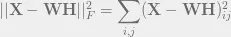Đây là thuật toán sinh ra để giải quyết vấn đề dữ liệu có quá nhiều chiều dữ liệu, cần giảm bớt chiều dữ liệu nhằm tăng tốc độ xử lí, nhưng vẫn giữ lại thông tin nhiều nhất có thể (high variance).
Chúng ta cần tìm ra chiều dữ liệu có độ quan trọng cao, nhằm giảm bớt việc tính toán, cũng như tăng tốc độ xử lí.
PCA chuyển dữ liệu từ linear thành các thuộc tính mới không liên quan lẫn nhau.
Dữ liệu.
Chúng ta cần phân biệt 2 loại dữ liệu:
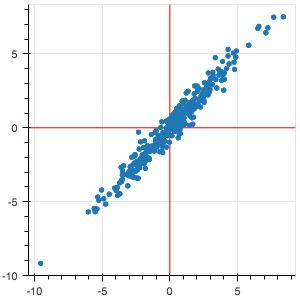
Dữ liệu liên quan (correlated):
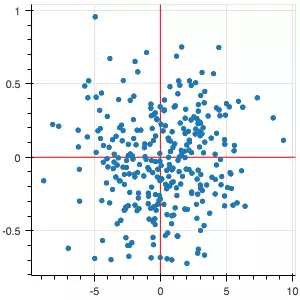
Dữ liệu không liên quan (uncorrelated):
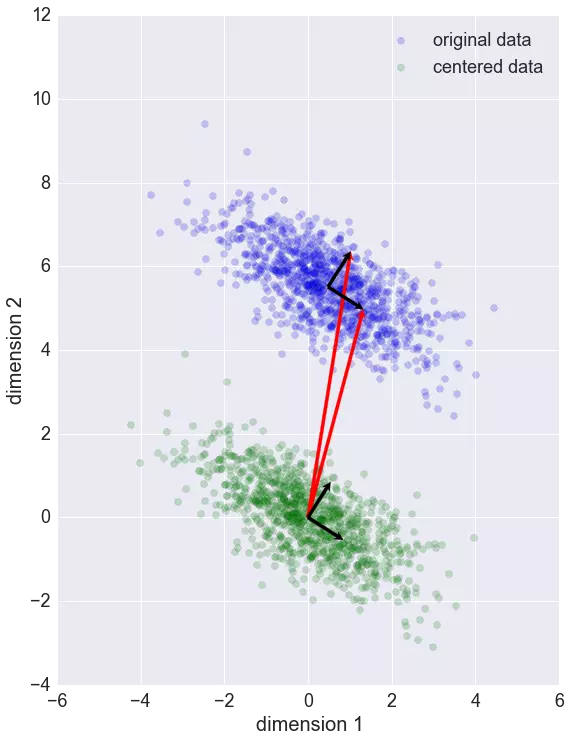
PCA tìm ra mean và principal components.
Làm thế nào để implement PCA:
Biến đổi X về dạng đồng nhất.
Tính toán covariance matrix Σ
Tìm eigenvectors của Σ
Lấy K dimensions có giá trị variance cao nhất
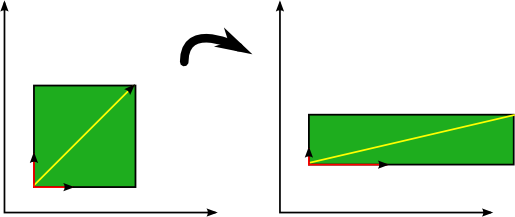
eigenvectors (vector màu đỏ)
là vector không thay đổi hướng khi apply linear transformation.
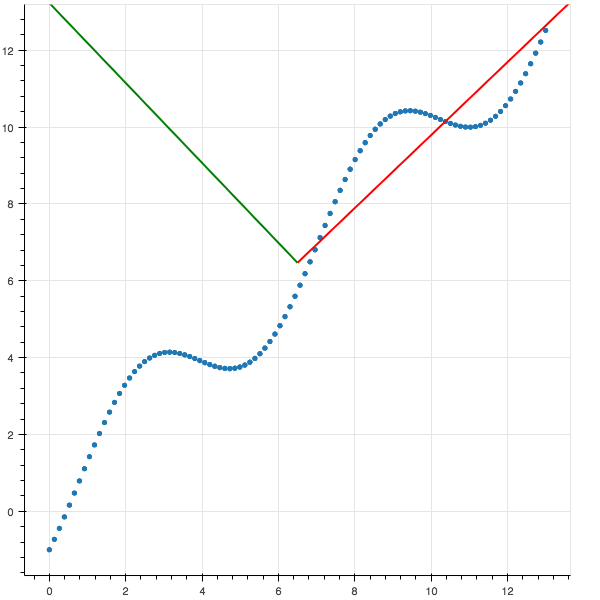
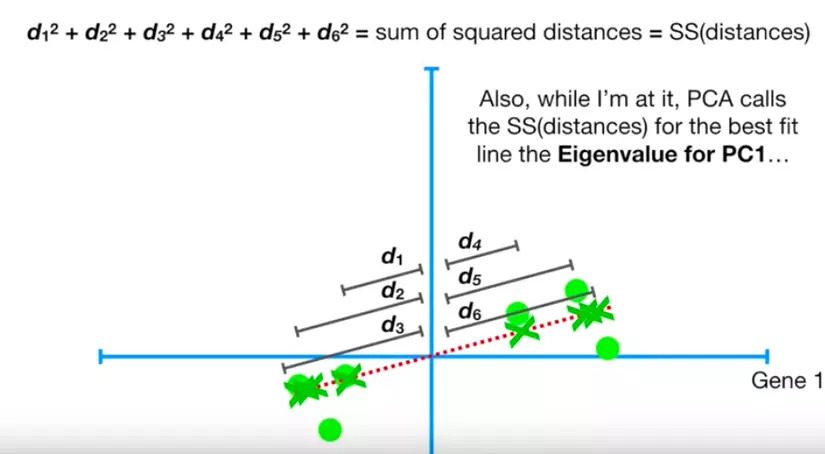
eigenvalue cho PC1
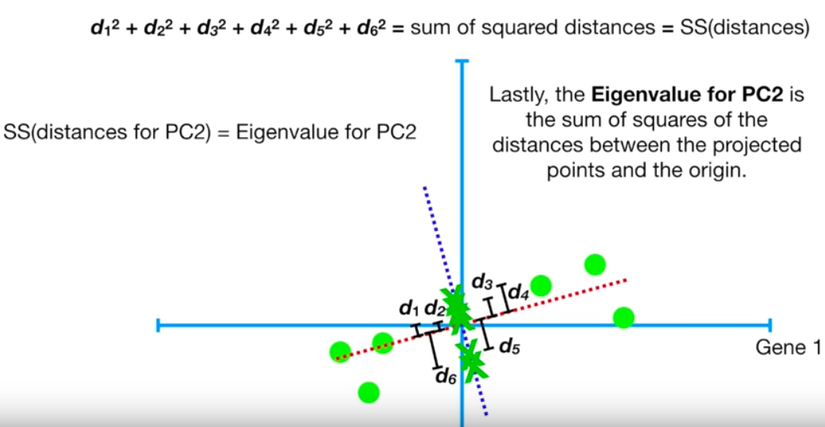
eigenvalue cho PC2
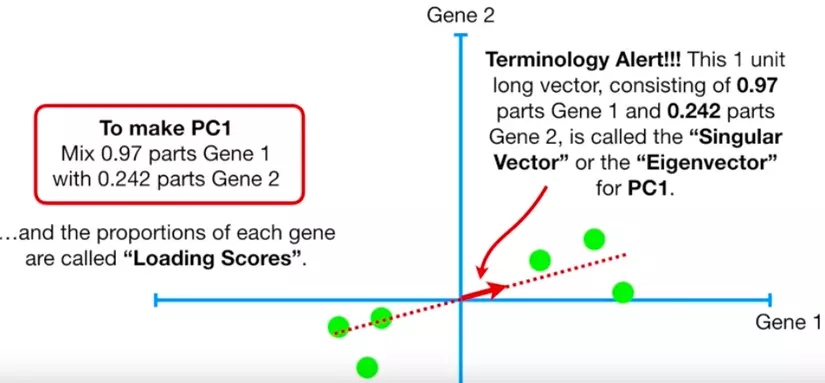
eigenvector
Sự phân bổ độ quan trọng của chiều dữ liệu
Algorithm
from numpy import array
from numpy import mean
from numpy import cov
from numpy.linalg import eig
# define a matrix
A = array([[1, 2], [3, 4], [5, 6]])
print(A)
# calculate the mean of each column
M = mean(A.T, axis=1)
print(M)
# center columns by subtracting column means
C = A - M
print(C)
# calculate covariance matrix of centered matrix
V = cov(C.T)
print(V)
# eigendecomposition of covariance matrix
values, vectors = eig(V)
print(vectors)
print(values)
# project data
P = vectors.T.dot(C.T)
print(P.T)
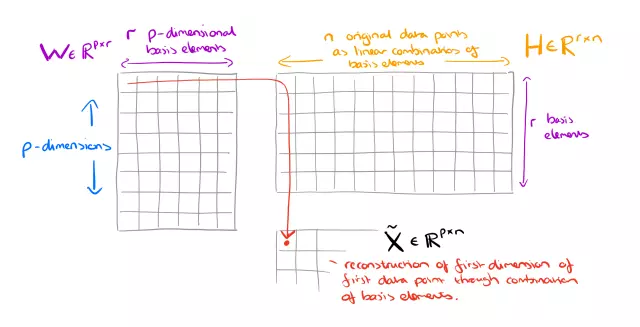
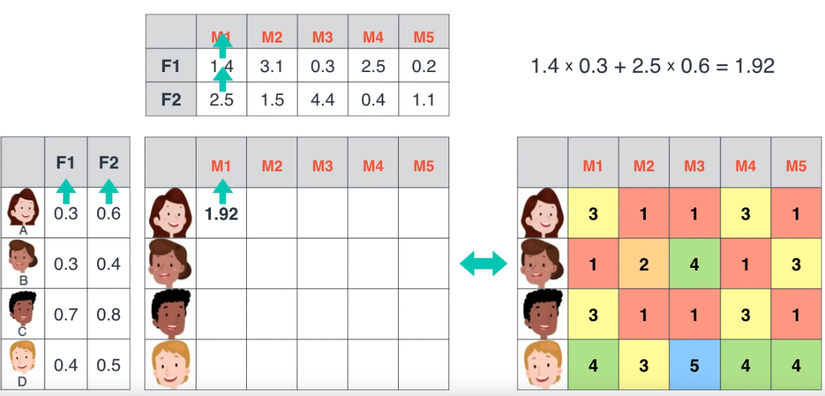
NMF chuyển một matrix X thành phép nhân 2 maxtrix cấp thấp hơn với độ xấp xỉ và sai số nhỏ. Mục đích để giảm cho việc lưu trữ và việc tính toán nhưng vẫn đảm bảo được các đặc điểm của dữ liệu (các đặc tính của mô hình).
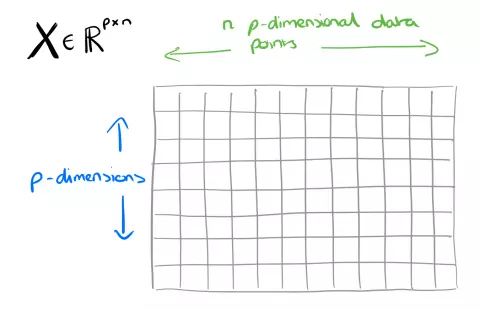
Như trên, chúng ta có một ma trận dữ liệu X (p x n), mục đích của NMF là giảm chiều dữ liệu từ p xuống r thông qua việc tìm 2 ma trận con có phép nhân ~= X Để làm được vậy chúng ta thông qua việc
random dữ liệu ban đầu.
So sánh các dữ liệu sinh ra với ma trận kết quả X.
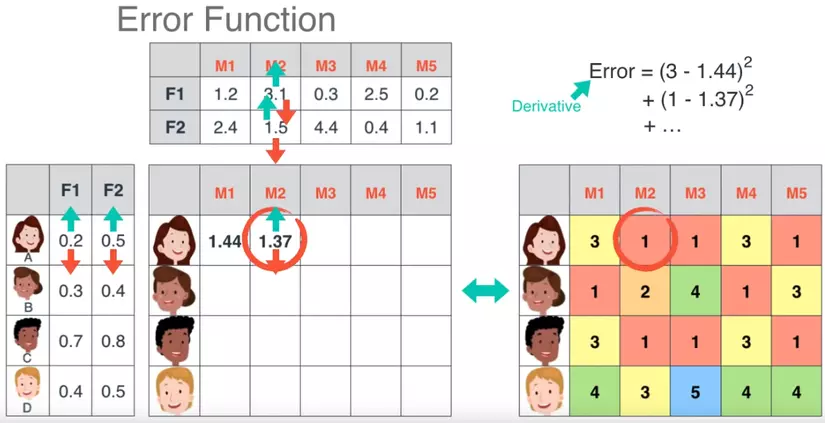
điều chỉnh lại các thông số cho hợp lí => để tối ưu hàm lỗi (error function).
lặp lại các bước trên cho đến khi lỗi đủ nhỏ (đủ tốt)
Ví dụ. (ứng dụng trong việc dự đoán phìm của netflix bình chọn của NMF):
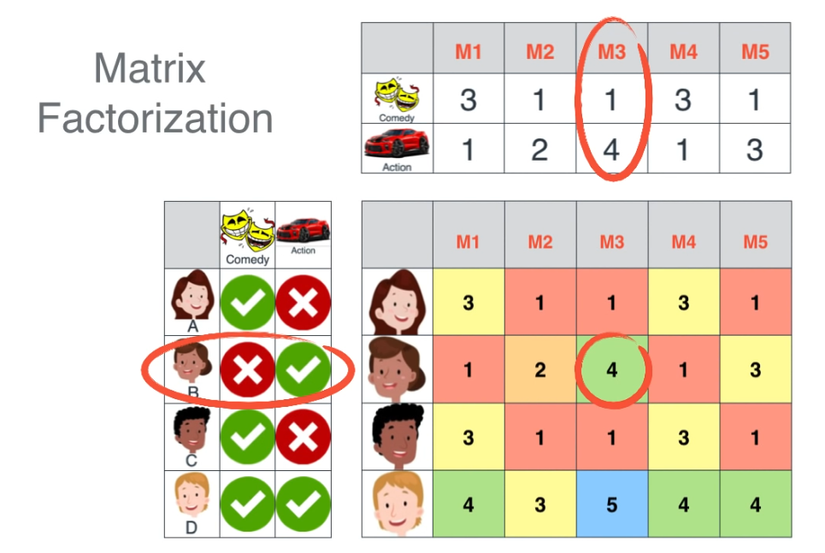
Chúng ta có 4 người, với 2 thể loại phim là "comedy" và "action", ma trận X tương đương với ma trận lớn, các con số là số điểm rating bộ phim) ma trận "trái" "trên" tương đương với các ma trận cần tìm (phân tách).
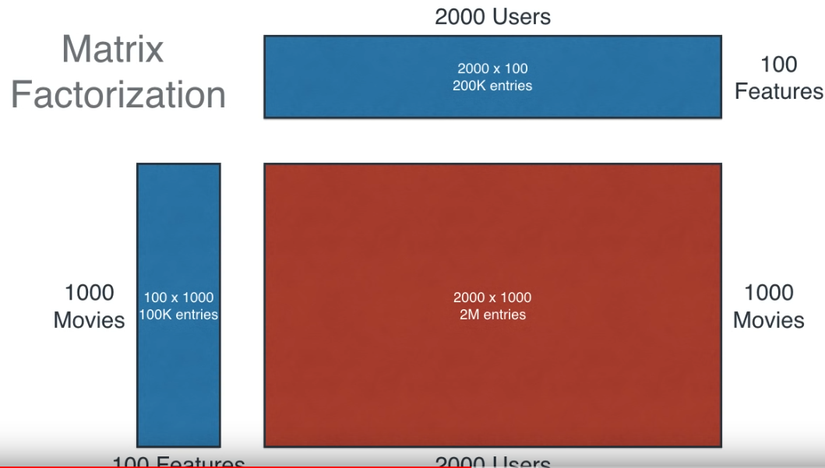
Như bạn thấy, với ma trận lớn ta cần 2 triệu entries để lưu trữ, trong khi việc phân tách ra 2 ma trận sẽ chỉ tốn 300.000 entries
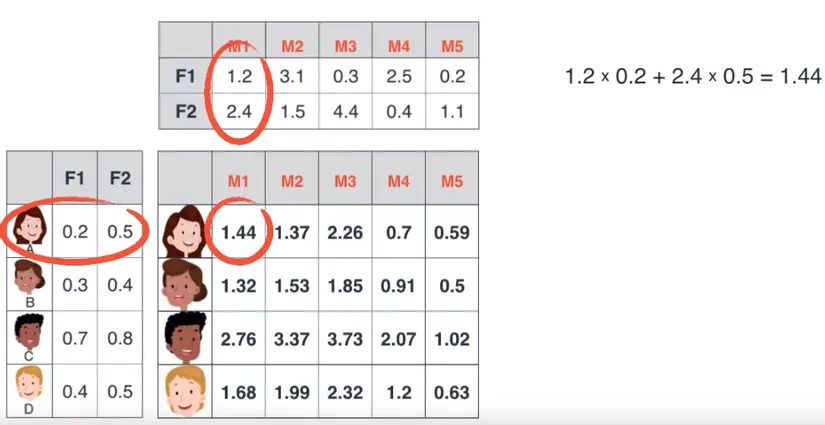
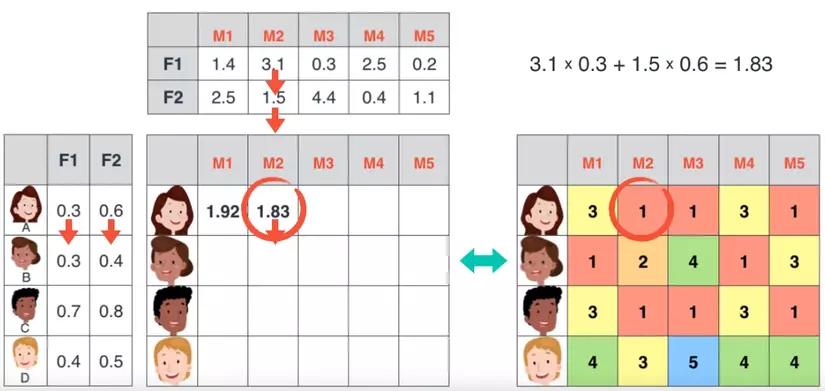
Để tìm được 2 ma trận này ta random các giá trị khởi tạo, tính toán và so sánh với ma trận gốc.
1.44 là nhỏ hơn 3, nên ta cần nâng các param lên.
Hoặc giảm xuống (như đối với giá trị tiếp theo).
Error function sẽ bằng tổng bình phương chênh lệch, đạo hàm của nó chính là cái chúng ta cần tối ưu.
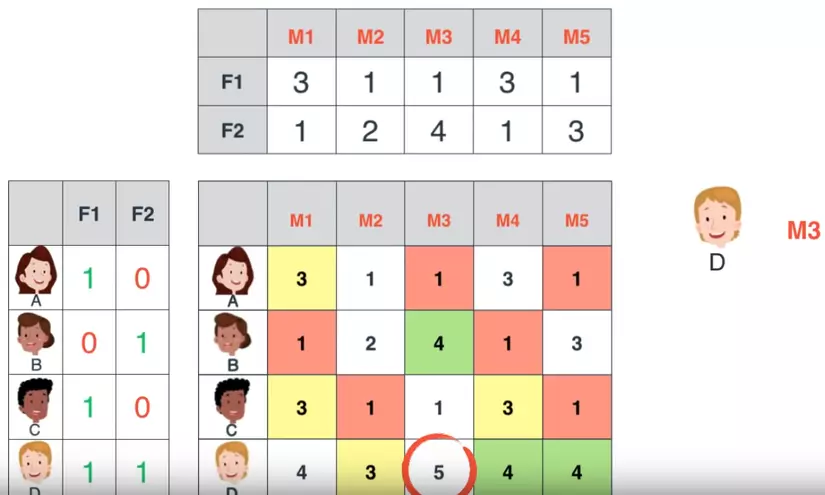
Sau khi tìm được 2 ma trận tương ứng, chúng ta có thể dự đoán được những điểm dữ liệu bị thiếu dựa vào việc nhân ma trận (vì dữ liệu thực tế thường không đầy đủ, rời rạc, chúng ta có thể filling các giá trị giả định, sau khi tìm được các ma trận phù hơp, chúng ta có thể quay lại dùng phép nhân ma trận để dự đoán các dữ liệu bị thiếu).
Hy vọng sẽ giúp bạn hiểu phần nào NMF. Cảm ơn mọi người (bow)
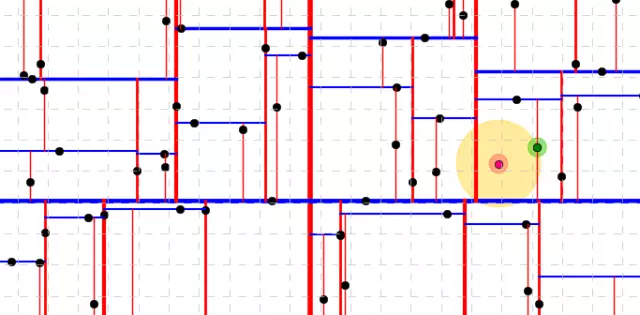
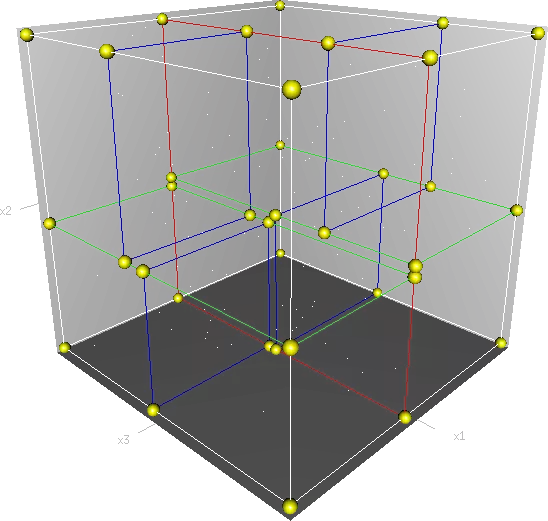
Kd-trees dùng để tìm kiếm các dữ liệu gần, liên quan nhất (neighbouring data points) trong miền không gian 2 chiều, hoặc nhiều chiều.
Kd-trees thuộc họ Nearest neighbor (NN) search.
Tóm tắt:
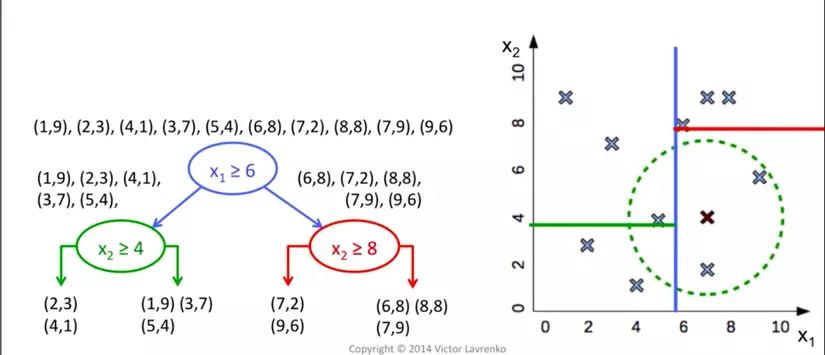
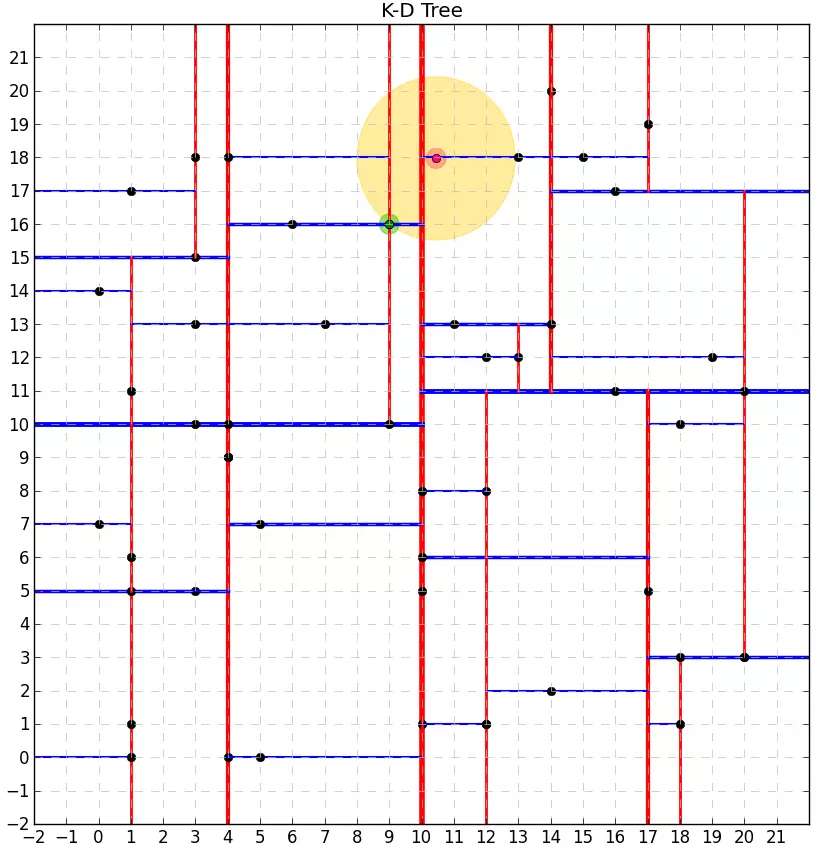
Cách build Kd-trees từ tranning data:
chọn 1 chiều random, tìm toạ độ trung bình, chia data theo toạ độ đó, lặp lại.
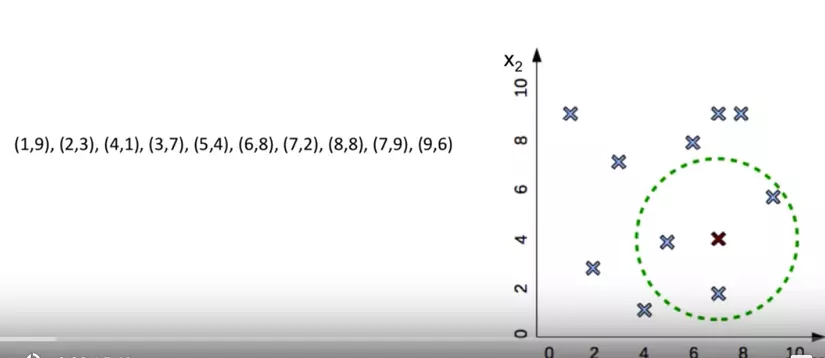
Cách tìm các dữ liệu liên quan cho point (7,4)
tìm các phân vùng chứa điểm (7,4)
so sánh khoảng cách điểm đó tới tất cả các điểm trong phân vùng để chọn cái gần nhất.
Chi tiết:
Code build tree:
from collections import namedtuple
from operator import itemgetter
from pprint import pformat

class Node(namedtuple('Node', 'location left_child right_child')):

    def __repr__(self):
        return pformat(tuple(self))

def kdtree(point_list, depth=0):
    """ build K-D tree
    :param point_list list of input points
    :param depth      current tree's depth
    :return tree node
    """

    # assumes all points have the same dimension
    try:
        k = len(point_list[0])
    except IndexError:
        return None

    # Select axis based on depth so that axis cycles through
    # all valid values
    axis = depth % k

    # Sort point list and choose median as pivot element
    point_list.sort(key=itemgetter(axis))
    median = len(point_list) // 2         # choose median

    # Create node and construct subtrees
    return Node(
        location=point_list[median],
        left_child=kdtree(point_list[:median], depth + 1),
        right_child=kdtree(point_list[median + 1:], depth + 1)
    )
Từ tree có được, ta build hàm tìm các điểm neighbour của một điểm cho trước:
Cách search như sau:
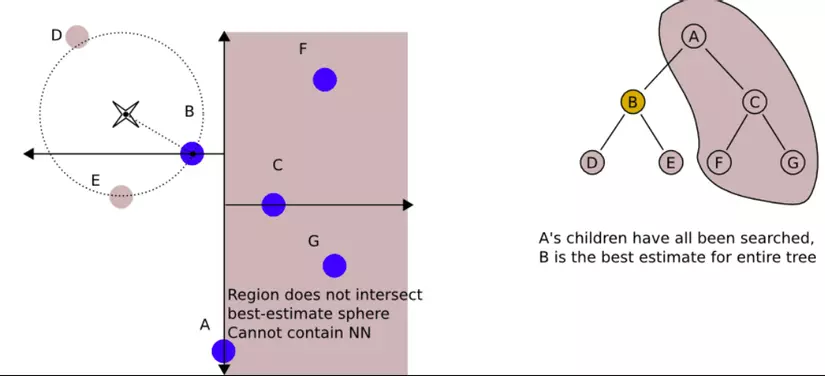
Bắt đầu root node, move qua các nhánh một cách đệ quy.
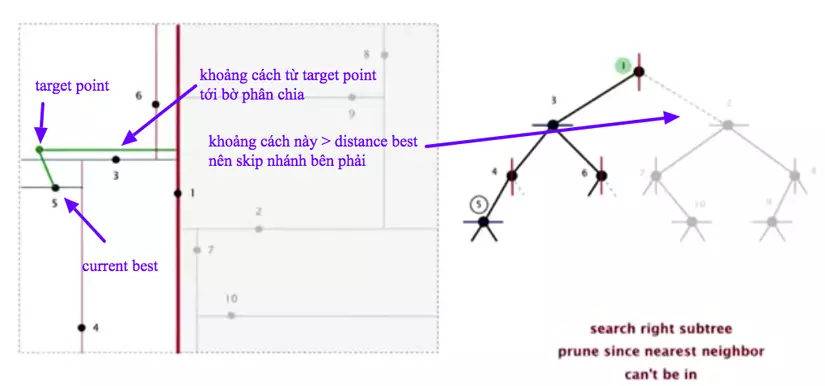
Trong khi lướt qua các nhánh, thuật toán sẽ lưu lại node có khoảng cách ngắn nhất với khoảng cách chưa target point (là điểm cần tìm neghibour), được gọi là current best (tốt nhất hiện tại)
Nếu node hiện tại gần target point hơn current best, nó sẽ trở thành current best.
Trong khi di chuyển nó sẽ check xem, với điểm current best ở nhánh trái thì distance best(khoảng cách từ target point tới current best) có ngắn hơn khoảng cách từ target point tới bờ phân chia hay không, nếu ngắn hơn tức là bên nhánh trái đã cho kết quả tốt nhất và ta không cần tìm tiếp bên phải, nếu dài hơn tức là có lẽ sẽ có 1 điểm nào đó bên phải cho khoảng cách tới target point tốt hơn nên ta phải tiếp tục loop qua các nhánh bên phải.
Với mỗi nhánh, thuật toán hoàn thành cho tới khi chạm leaf node.
Code
nearest_nn = None           # nearest neighbor (NN)
distance_nn = float('inf')  # distance from NN to target

def nearest_neighbor_search(tree, target_point, hr, distance, nearest=None, depth=0):
    """ Find the nearest neighbor for the given point (claims O(log(n)) complexity)
    :param tree         K-D tree
    :param target_point given point for the NN search
    :param hr           splitting hyperplane
    :param distance     minimal distance
    :param nearest      nearest point
    :param depth        tree's depth
    """

    global nearest_nn
    global distance_nn

    if tree is None:
        return

    k = len(target_point)

    cur_node = tree.location         # current tree's node
    left_branch = tree.left_child    # its left branch
    right_branch = tree.right_child  # its right branch

    nearer_kd = further_kd = None
    nearer_hr = further_hr = None
    left_hr = right_hr = None

    # Select axis based on depth so that axis cycles through all valid values
    axis = depth % k

    # split the hyperplane depending on the axis
    if axis == 0:
        left_hr = [hr[0], (cur_node[0], hr[1][1])]
        right_hr = [(cur_node[0],hr[0][1]), hr[1]]

    if axis == 1:
        left_hr = [(hr[0][0], cur_node[1]), hr[1]]
        right_hr = [hr[0], (hr[1][0], cur_node[1])]

    # check which hyperplane the target point belongs to
    if target_point[axis] <= cur_node[axis]:
        nearer_kd = left_branch
        further_kd = right_branch
        nearer_hr = left_hr
        further_hr = right_hr

    if target_point[axis] > cur_node[axis]:
        nearer_kd = right_branch
        further_kd = left_branch
        nearer_hr = right_hr
        further_hr = left_hr

    # check whether the current node is closer
    dist = (cur_node[0] - target_point[0])**2 + (cur_node[1] - target_point[1])**2

    if dist < distance:
        nearest = cur_node
        distance = dist

    # go deeper in the tree
    nearest_neighbor_search(nearer_kd, target_point, nearer_hr, distance, nearest, depth+1)

    # once we reached the leaf node we check whether there are closer points
    # inside the hypersphere
    if distance < distance_nn:
        nearest_nn = nearest
        distance_nn = distance

    # a nearer point (px,py) could only be in further_kd (further_hr) -> explore it
    px = compute_closest_coordinate(target_point[0], further_hr[0][0], further_hr[1][0])
    py = compute_closest_coordinate(target_point[1], further_hr[1][1], further_hr[0][1])

    # check whether it is closer than the current nearest neighbor => whether a hypersphere crosses the hyperplane
    dist = (px - target_point[0])**2 + (py - target_point[1])**2

    # explore the further kd-tree / hyperplane if necessary
    if dist < distance_nn:
        nearest_neighbor_search(further_kd, target_point, further_hr, distance, nearest, depth+1)
Chạy thử:
Dùng với scikit-learn:
Dùng sklearn:
>>> import numpy as np
>>> np.random.seed(0)
>>> X = np.random.random((10, 3))  # 10 points in 3 dimensions
>>> tree = KDTree(X, leaf_size=2)
>>> dist, ind = tree.query([X[0]], k=3)
>>> print(ind)  # indices of 3 closest neighbors
[0 3 1]
>>> print(dist)  # distances to 3 closest neighbors
[ 0.          0.19662693  0.29473397]
Một trong những điểm nổi bật của Golang là goroutine, nó có gì nổi bật để khiến cho cocurrency trong Go trở nên dễ dàng như vậy
Cấu trúc:
Một goroutine được khởi tạo với chỉ 2KB trong stack size
Goroutines chứa trong ít stack size nhưng có thể tự grow khi cần, thông thường sẽ có hàng trăm nghìn goroutines bên trong chương trình của bạn. Điều này cho phép lập trình viên use concurrency structure bên trong chương trình mà không cần quan tâm có bị overhead hay không.
Goroutines chính là function executing concurrently cùng lúc với các goroutines khác trên cùng địa chỉ space
Cấu trúc code:
struct P
{
    Lock;
    G *gfree; // freelist, moved from sched
    G *ghead; // runnable, moved from sched
    G *gtail;
    MCache *mcache; // moved from M
    FixAlloc *stackalloc; // moved from M
    uint64 ncgocall;
    GCStats gcstats;
    // etc
    ...
};

P *allp; // [GOMAXPROCS]

type schedt struct {
 glock mutex
 gfree *g
     Ngfree int32
}
Go scheduler.
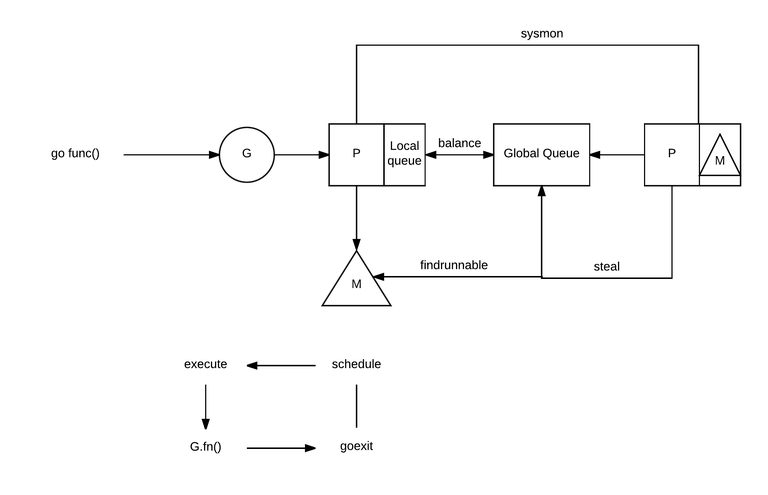
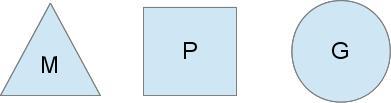
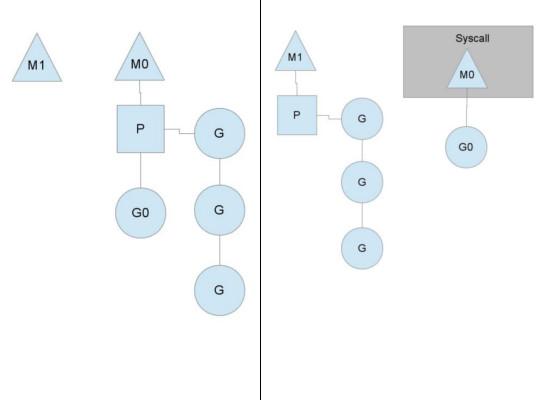
Go Scheduler có 3 thành phần chính:
Hình tam giác đại diện cho OS thread, thread là luồng thực thi được quản lí bởi OS.
Hình tròn đại diện cho goroutine, nó bao gồm stack, pointer, và các thông tin quan trọng cho việc quản lí scheduling goroutines.
Hình chữ nhật đại diện cho context của scheduling. Nó được coi như phiên bản single thread trong golang.
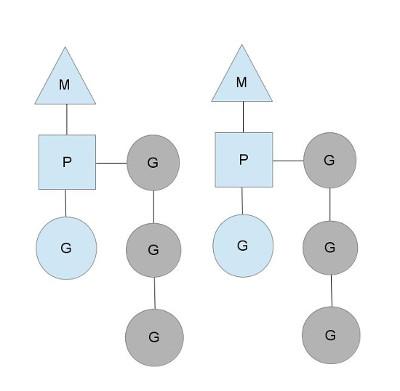
Như các bạn thấy có 2 loại queue trong golang là global queue và local queue, và mỗi P duy trì một chuỗi G đang chạy.
Để thực thi được goroutine, M cần được trong context của P. Machine, sau đó sẽ pop goroutine ra khỏi queue P và thực thi code.
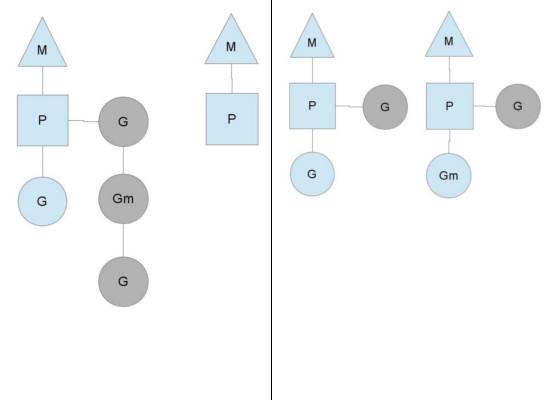
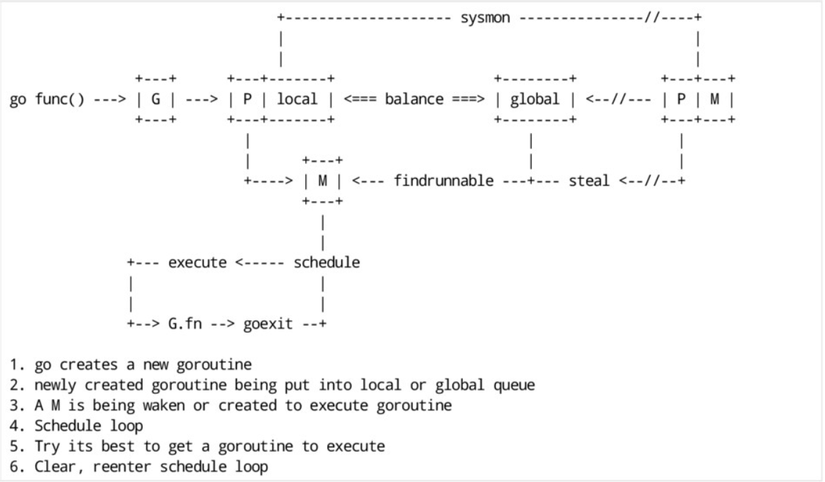
Khi chúng ta tạo thực thi cuộc gọi: go func(), thì nó sẽ được đặt vào trong P queue. Và đây là mấu chốt trong thuật toán đánh cắp công việc (work-stealing scheduling algorithm), cái mà sẽ chạy khi M kết thúc thực thi một số G và thử một số G khác bên ngoài queue hiện tại, nếu queue hiện tại mà rỗng, nó sẽ random chọn P(gọi là P1) khác và thử đánh cắp một nửa số goroutine G khỏi queue P1.
Tại sao chúng ta lại cần context P.
Lí do cho việc có context P là để đánh cắp số lượng Goroutine G từ một threads khác nếu thread đang chạy bị block vì một lí do nào đó.
Ví dụ chúng ta cần block thread vì cần chờ người dùng nhập input (syscall) hay connect với DB chẳng hạn. Một thread không thể vừa bị block vừa thực thi code được, nên chúng ta cần khái niệm context để giữ việc scheduling.
Nhằm giúp những người có sở thích nuôi thú cưng có thể quản lí mọi việc liên quan đến động vật cưng của mình, mình đã đưa ra ứng dụng quản lí mọi vấn đề liên quan đến thú cưng.
Ứng dụng có các chức năng :
Quản lí, đặt lịch hẹn giờ báo về các hoạt động hằng ngày như cho ăn, dắt đi vệ sinh, hay tắm cho vật nuôi
Lưu thông tin các thú cưng của mình.
Quản lí giá cả các đồ ăn, vật phẩm của thú cưng.
Lưu lại các âm thanh để gọi thú cưng.
Quản lí các liên lạc bằng email và phone tới những người liên quan tới việc chăm sóc thú cưng như bác sĩ, cửa hàng bán thức ăn.
Đây là ứng dụng đọc tin tức dựa trên các mẫu tin rút gọn gọi là RSS (Định nghĩa Wiki RSS), giúp bạn đọc các tin tức một cách nhanh chóng, tổng thể mà không cần đọc hết bài viết.
Ứng dụng có các chức năng:
Liệt kê các danh sách các báo phổ biến hiện nay.
Hiển thị các mẩu tin tức nhỏ liên quan tới báo đó dựa trên phân loại nội dung.
Dựa vào website http://tracau.vn/ và các API được họ cung cấp, tôi đã làm ra một ứng dụng trên nền window phone giúp mọi người dễ dàng sử dụng tính năng này. Ứng dụng có các tính năng cơ bản sau:
Tra các câu tiếng anh dựa trên từ ngữ được tìm kiếm, kể cả bạn gõ tiếng việt hay tiếng anh.
Phát âm các câu đó.
Có thể lưu lại các câu ưa thích dựa trong kết quả tìm hiểu.
Xem lại các câu ưa thích và có thể xóa bỏ nó.
Xem lại lịch sử tra câu, các từ đã tra dựa theo ngày.